סדרת "מאפס" · חלק 5 מתוך 9
"הארון לא נכנס לחדר, כי הוא היה גדול מדי." איך הטרנספורמר, המנוע של צ'אט GPT, יודע מי זה "הוא"?
מי היה גדול מדי? אתם יודעים מיד. למחשבים זה היה קשה מאוד, עד מאמר אחד של גוגל מ-2017. הרעיון מהמאמר הזה הוא המנוע שמאחורי צ'אט GPT.
הארון והחדר מחכים לכם בפנים. נבנה את הרעיון חוט אחרי חוט, ובכל צעד תראו את החוטים על המסך ותלחצו עליהם בעצמכם.
"הארון לא נכנס לחדר, כי הוא היה גדול מדי."
מי היה גדול מדי? הארון, ברור.
"הארון לא נכנס לחדר, כי הוא היה קטן מדי."
ועכשיו? החדר.
שימו לב מה קרה כאן. המילה "הוא" לא השתנתה. גם הדקדוק לא עוזר, כי גם ארון וגם חדר הם בלשון זכר.
מה שקבע את התשובה הוא מילה אחת שבאה אחרי "הוא": גדול או קטן. כדי להבין את "הוא", הראש שלכם החזיק את כל המשפט בבת אחת, קדימה ואחורה, ומצא לאיזו מילה הוא קשור.
למחשבים זה היה קשה מאוד. ואת הדרך שבה למדו לעשות את זה מתאר מאמר אחד, שפרסמו חוקרים של גוגל (Google) ביוני 2017. בואו נעשה סדר, צעד אחרי צעד, מאפס.
כדי שיהיה קל יותר להבין, מומלץ לקרוא קודם שני מאמרים:
- ביט ובינארי: איך מילה הופכת למספרים בתוך מחשב.
- איך הצ'אט יודע לענות: מודל שפה לומד לנחש את המילה הבאה.
כאן נבין איך הוא קורא את המשפט כדי לנחש טוב.
צעד 1: מה המחשב בכלל צריך לעשות
מחשב לא יודע מה זה ארון. מה שהוא מקבל זה רצף של מילים, ולמעשה רצף של מספרים (על איך מילה הופכת למספרים: ביט, 0 ו-1).
כדי לתרגם משפט לאנגלית, או לנחש איזו מילה תבוא עכשיו, הוא צריך לדעת דבר אחד לכל מילה: מה היא אומרת כאן, במשפט הזה.
וזה הקושי. אותה מילה אומרת דברים שונים לפי מה שסביבה.
"הוא" יכול להיות הארון או החדר. "קפה" יכול להיות משקה, או בית קפה ("נפגשנו בקפה"). אי אפשר להבין מילה לבד: צריך לדעת לאילו מילים אחרות היא קשורה.
צעד 2: כותרות וחוטים
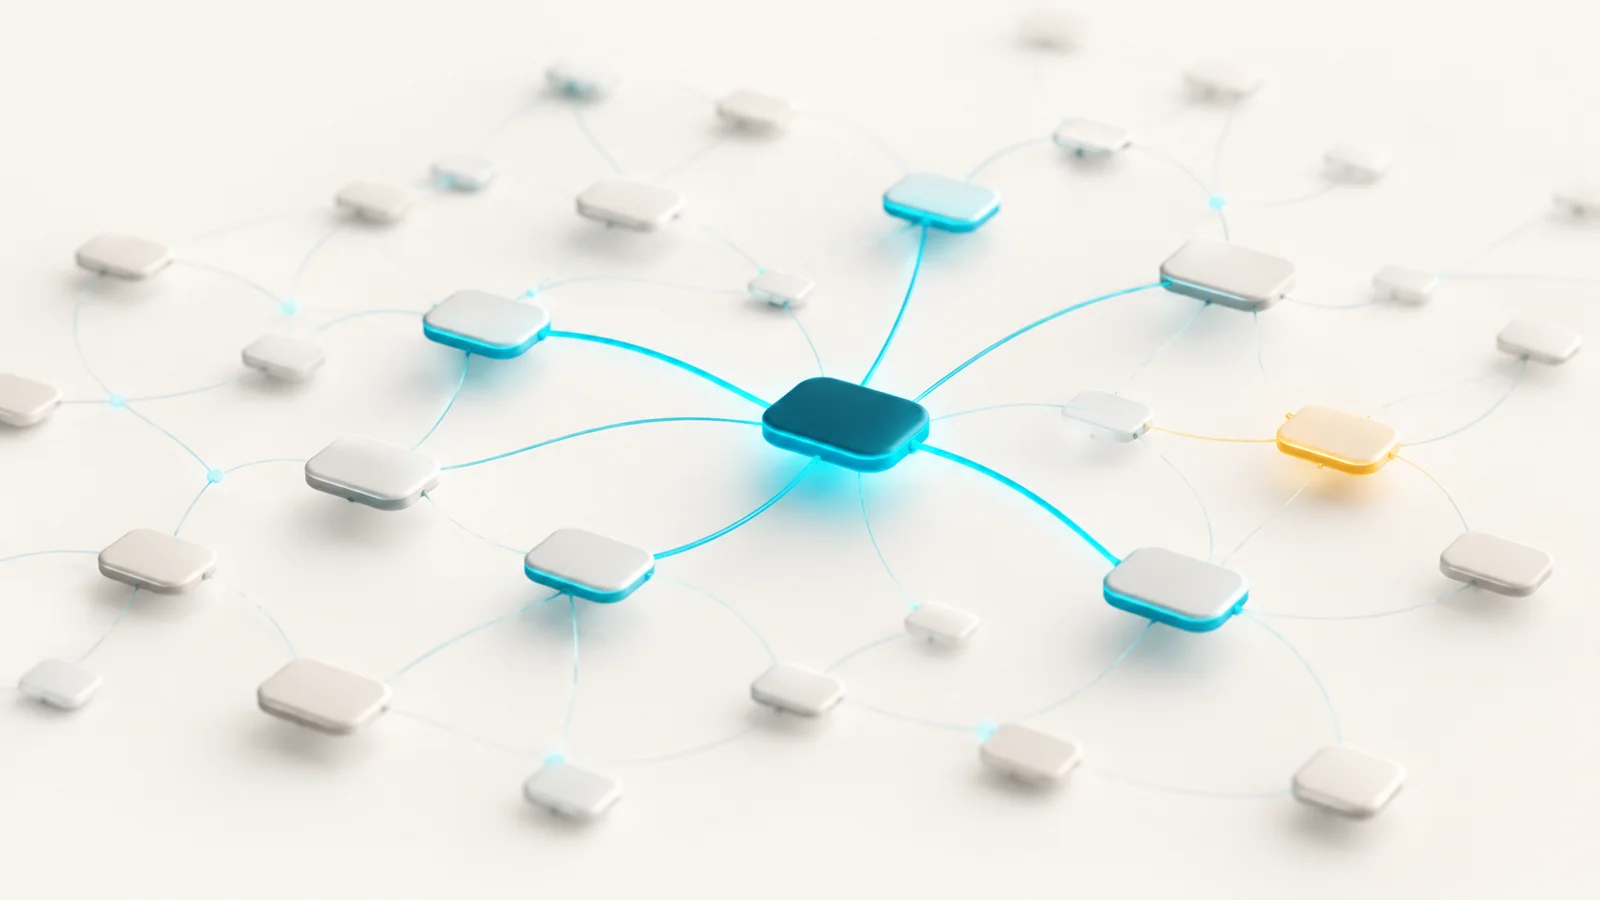
הנה הדימוי שילווה אותנו עד הסוף. תחשבו מה קורה בראש כשאתם שומעים את המילה "ארון". לא עולה רק המילה.
עולים איתה כל הדברים שקשורים אליה: רהיט, כבד, דלתות, בגדים, הובלה. "ארון" הוא כמו כותרת, ומתחתיה תלויים בחוטים כל הדברים האלה.
חלק מהחוטים עבים. בין "ארון" ל"בגדים" יש קשר חזק. חלק דקים: בין "ארון" ל"עץ" יש קשר, אבל חלש יותר. ולפעמים חוט מתעבה בגלל ההקשר: כשמדברים על הובלה, החוט בין "ארון" ל"כבד" נעשה פתאום הכי חשוב.
עכשיו קחו משפט. כל מילה בו היא כותרת כזאת. אבל כאן מעניינים אותנו רק החוטים בין המילים שבמשפט עצמו: מ"הוא" אל "הארון", מ"הוא" אל "גדול". להבין משפט זה לדעת אילו חוטים חשובים עכשיו.
במשפט שלנו, החוט מ"הוא" אל "הארון" חשוב מאוד, והחוט מ"הוא" אל "כי" כמעט לא.
זה דימוי, לא תיאור של המוח האמיתי, וגם לא של מה שקורה בתוך המחשב. המחשב עובד עם מספרים, לא עם חוטים. אבל הדימוי קרוב מאוד לרעיון שגוגל הציעה: לתת לכל מילה לבדוק ישר את החוטים שלה לכל המילים האחרות.
צעד 3: איך עשו את זה לפני 2017. קריאה בשורה
השיטה הנפוצה ביותר לפני 2017 קראה משפט כמו מי שמקריא לעצמו מכתב ארוך: מילה אחרי מילה, מההתחלה לסוף, ומחזיק בראש רק סיכום קצר של מה שהיה עד עכשיו.
כל מילה חדשה נכנסת לסיכום, ומשהו ממה שהיה קודם נדחק החוצה. אין לו את כל הכותרות מול העיניים. יש לו רק את הסיכום.
לקריאה בשורה יש שתי בעיות.
בעיה ראשונה: ההתחלה דוהה. עד שהקורא מגיע ל"הוא", "הארון" כבר עבר דרך הסיכום כמה פעמים, וכל פעם נשאר ממנו קצת פחות.
במשפט של עשר מילים זה עוד בסדר. בפסקה של מאה מילים, מה שנאמר בהתחלה כמעט נמחק.
בעיה שנייה: כולם מחכים. אי אפשר לקרוא את המילה העשירית לפני שגמרו את התשיעית, כי הסיכום עוד לא מוכן. גם אם יש לכם מאה עוזרים, הם עומדים בתור. וזו הבעיה שעלתה הכי הרבה כסף: מחשבים יקרים שעומדים בתור הם מחשבים ששילמו עליהם והם לא עובדים.
צעד 4: יוני 2017. המאמר עם הכותרת המוזרה
ביוני 2017 העלו חוקרים של גוגל מאמר לאתר של מאמרים מדעיים.
הכותרת: "Attention Is All You Need", כלומר "קשב זה כל מה שצריך". בתוך המאמר הם נתנו שם לשיטה החדשה: טרנספורמר (Transformer), בעברית: "המשנה" או "הממיר".
מה הם הציעו? לבטל את הקריאה בשורה. לגמרי, ולהשאיר רק את החוטים. בתקציר המאמר הם כותבים שהשיטה שלהם בנויה "רק על מנגנוני קשב", ומוותרת "לגמרי" על הקריאה ברצף.
המקור באנגלית
based solely on attention mechanisms, dispensing with recurrence and convolutions entirelyאוהבים היסטוריה? לחצו כאן כדי לקרוא מאיפה בא הקשב
את הקשב, כלומר את החוטים בין המילים, הכירו כבר לפני 2017, כתוספת לקריאה בשורה: המחשב עדיין קרא מילה אחרי מילה, והחוטים עזרו לו להציץ אחורה.
החידוש של המאמר היה לוותר על השורה לגמרי, ולהשאיר רק את החוטים.
המשימה שעליה בדקו את זה הייתה תרגום: מאנגלית לגרמנית ומאנגלית לצרפתית.
התוצאה, לפי המאמר: שיא חדש בתרגום (במבחן שבו החוקרים בתחום משווים את התרגומים שלהם), ובחלק קטן מזמן האימון של השיטות הקודמות.
אז מה זה הקשב הזה, שעליו הם בנו הכול? כאן החוטים חוזרים לתמונה.
צעד 5: מה זה "קשב"? כל מילה מדליקה את החוטים שלה
עכשיו לב העניין. במקום לקרוא בשורה, הטרנספורמר פורש את כל המשפט בבת אחת: כל המילים, כמו כל הכותרות, וביניהן חוטים מכל מילה לכל מילה. אין סיכום שעובר מיד ליד.
כשהמילה "הוא" רוצה להבין למי היא מתכוונת, היא לא מחכה לסיכום. היא בודקת ישר כל חוט שיוצא ממנה, ושואלת: כמה הקשר הזה חשוב לי עכשיו?
- החוט ל"הארון"? חשוב מאוד. ארון הוא דבר שיכול להיות גדול מדי.
- החוט ל"גדול"? חשוב מאוד. זו המילה שאומרת על מי מדובר.
- החוט ל"לחדר"? קצת. גם חדר יכול להיות "הוא".
- החוטים ל"לא", "כי", "מדי"? כמעט בכלל לא.
החוטים החשובים נדלקים ומתעבים. השאר נשארים דקים.
אחר כך "הוא" מעדכן את מה שהוא יודע על עצמו, בעיקר לפי מה שנמצא בקצה החוטים הדולקים. מעכשיו "הוא" כבר לא סתם "הוא". הוא "הוא, כלומר הארון".
זה כל הקשב (Attention): כל מילה בודקת את החוטים שלה לכל המילים האחרות, מחליטה אילו להדליק ובכמה, ומתעדכנת.
ולפני שאתם חושבים שזה קורה רק ל"הוא": כל המילים עושות את זה, כל אחת לעצמה, באותו זמן.
אוהבים טכנולוגיה? לחצו כאן כדי לקרוא איך נקבע העובי של כל חוט
לכל מילה במשפט יש שלושה דברים.
מה אני מחפשת: אצל "הוא" כתוב משהו כמו "אני מחפשת דבר בלשון זכר, שיכול להיות גדול או קטן".
מה אני מציעה: אצל "הארון" כתוב משהו כמו "אני חפץ, בלשון זכר, אפשר להזיז אותי". אצל "לחדר": "אני מקום, בלשון זכר".
מה אני מוסרת: מה שיעבור בחוט למילה שתדליק אותו.
העובי של החוט הוא עד כמה "מה אני מחפשת" של "הוא" מתאים ל"מה אני מציעה" של כל מילה אחרת. התאמה גבוהה, חוט עבה.
אחר כך הופכים את העוביים לאחוזים, שביחד יוצאים מאה. ו"הוא" לוקח מכל מילה חלק ממה שהיא מוסרת, לפי האחוז שלה.
במאמר קוראים לשלושת הדברים האלה שאילתה, מפתח וערך (Query, Key, Value). ומה שכתוב בהם הוא לא מילים כמו כאן, אלא רשימות של מספרים. מה שהמודל לומד באימון הוא בדיוק זה: איך לכתוב אותם, כדי שהחוטים הנכונים יתעבו.
נסו בעצמכם: גדול או קטן
בהדגמה הבאה, המספר ליד כל מילה אומר כמה מתשומת הלב של המילה שבחרתם הולך אליה. ביחד זה מאה אחוז.
נסו בעצמכם: לחצו על מילה במשפט, וראו אילו חוטים נדלקים לה. אחר כך החליפו את "גדול" ב"קטן", ולחצו שוב על "הוא".
הדגמה: המשפט "הארון לא נכנס לחדר כי הוא היה גדול מדי". לוחצים על "הוא" ורואים שהחוט העבה שלו הולך ל"הארון". כשמחליפים ל"קטן מדי", החוט העבה עובר ל"לחדר".
מה ראיתם? מילה אחת בסוף המשפט, "גדול" או "קטן", העבירה את החוט העבה של "הוא" מהארון לחדר. בקריאה בשורה, כשמגיעים ל"הוא", המילה הזאת עוד לא נקראה, כי היא באה אחריו. ברשת, היא שם מההתחלה, והחוט אליה מוכן.
רוצים לראות שזה קורה גם במודל אמיתי? לחצו כאן
בבלוג של גוגל הביאו בדיוק זוג משפטים כזה, באנגלית, על חיה שלא חצתה רחוב, ובכל משפט "it" מתכוון למשהו אחר: באחד לחיה, ובשני לרחוב. הם הראו בציור שהמודל אכן "הדליק" את החוט הנכון בכל אחד מהם.
צעד 6: תווית עם מספר המקום
רגע, אם כל המשפט פרוס בבת אחת, איך יודעים מה בא קודם? "הארון לא נכנס לחדר" ו"החדר לא נכנס לארון" הן אותן מילים בסדר אחר, ומשמעות הפוכה.
בקריאה בשורה, הסדר היה ברור מעצמו. ברשת, הוא הולך לאיבוד.
הפתרון: על כל כותרת נתלית תווית עם מספר המקום שלה. אני המילה הראשונה, אני השנייה, אני השלישית. כשמילה בודקת את החוטים שלה, היא יודעת גם מה בקצה כל חוט וגם איפה הוא עומד במשפט.
אוהבים טכנולוגיה? לחצו כאן כדי לקרוא על כמה סוגי חוטים וכמה סבבים של מחשבה
כמה סוגי חוטים במקביל. בין שתי מילים יכולים להיות כמה סוגים של קשר: קשר של משמעות, קשר של "מי עשה מה למי", קשר של זמן.
לכן בטרנספורמר כל מילה בודקת את החוטים שלה כמה פעמים במקביל, וכל בדיקה יכולה לחפש סוג אחר של קשר. (מה בדיוק כל אחד מחפש, המודל קובע לבד באימון. הדוגמאות כאן רק להמחשה.) במודל הבסיסי של המאמר היו שמונה בדיקות כאלה, והן נקראות "ראשים" (heads).
כמה סבבים של מחשבה. זה לא נגמר בסבב אחד. אחרי שכל המילים התעדכנו לפי החוטים שלהן, מתחיל סבב נוסף: כל מילה בודקת שוב את החוטים, אבל עכשיו כל הכותרות כבר יודעות יותר, והקשרים מתחדדים.
במאמר היו שישה סבבים כאלה, אחד מעל השני. כל סבב נקרא "שכבה". במודלים שבאו אחר כך יש הרבה יותר סבבים. ב-GPT-3 של אופן איי איי (OpenAI), למשל, היו 96 (2020).
המקור באנגלית
In this work we employ h=8 parallel attention layers, or heads. ... The encoder is composed of a stack of N=6 identical layers. ... Since our model contains no recurrence and no convolution, in order for the model to make use of the order of the sequence, we must inject some information about the relative or absolute position of the tokens in the sequence.ועוד הערה קטנה: המודל לא באמת קורא מילים שלמות אלא חתיכות טקסט שנקראות טוקנים (על זה במאמר על מודל שפה). כדי לא לסבך, כאן אנחנו קוראים להן מילים.
צעד 7: למה זה שינה הכול. כל החוטים בבת אחת
עד עכשיו דיברנו על הבנה. אבל הדבר הכי גדול שהרשת נתנה הוא מהירות.
תזכרו את הבעיה השנייה של הקריאה בשורה: כולם מחכים. אם במשפט יש מאה מילים, צריך מאה צעדים, אחד אחרי השני. לא משנה כמה מחשבים יש לכם.
ברשת אין תור. כל המילים בודקות את החוטים שלהן באותו רגע. מאה מילים? כולן חושבות ביחד. ולזה בדיוק בנויים המעבדים הגרפיים (GPU): לא חישוב אחד ענק, אלא המון חישובים קטנים באותו זמן.
בבלוג של גוגל כתבו שהטרנספורמר מתאים הרבה יותר לחומרה של היום, שמצטיינת בעבודה במקביל ולא בעבודה ברצף, ושהוא מאיץ את האימון "עד פי עשרה". כלומר, אימון שלקח עשרה ימים יכול לקחת יום אחד.
המקור באנגלית
a much better fit for modern machine learning hardware, speeding up training by up to an order of magnitudeנסו בעצמכם: קורא אחד שעובר על הטקסט מילה אחרי מילה, מול עשרה קוראים שמתחילים באותו רגע.
הדגמה: אותו משפט נקרא פעמיים. פעם בתור, מילה אחרי מילה (20 צעדים), ופעם עשרה קוראים ביחד (2 צעדים). עוזרים לקורא בתור לא מקצרים את הזמן.
מה ראיתם? הקורא היחיד לא יכול ללכת מהר יותר מהקצב שלו, גם אם תוסיפו לו עוזרים, כי כל מילה מחכה לקודמת. אצל העשרה, ככל שיש יותר ידיים, נגמר מהר יותר.
ועכשיו תחשבו רגע מה יוצא מזה. אם ללמד מודל על ספר אחד לוקח פחות זמן, אפשר באותו זמן ובאותו כסף ללמד אותו על יותר ספרים. וכשמוסיפים מעבדים, הם באמת עוזרים, כי אף אחד לא עומד בתור.
המהירות הזאת היא אחת הסיבות שבשנים שאחרי אפשר היה ללמד מודלים על כמויות טקסט גדולות בהרבה, יחד עם הרבה יותר מעבדים וכסף. (זו פרשנות שלנו: המאמר עצמו בדק רק תרגום.)
צעד 8: מה ה-T ב-GPT?
המאמר נכתב בשביל תרגום. אבל מהר מאוד התברר שהרשת הזאת טובה לכל דבר שיש בו טקסט.
- 2018: אופן איי איי (OpenAI), החברה שמאחורי צ'אט GPT, פרסמה מודל שלמד מהרבה טקסט לפני שלימדו אותו משימות. במאמר הם כותבים במפורש: "אנחנו משתמשים בטרנספורמר". למודל הזה קראו אחר כך GPT הראשון.
אז מה זה GPT? ראשי תיבות של Generative Pre-trained Transformer. שלוש מילים.
Generative: יוצר, כותב טקסט חדש. Pre-trained: עבר אימון מוקדם על הרבה טקסט (בדיוק השלב שמוסבר במאמר על מודל שפה). Transformer: בנוי על הרשת מ-2017.
במילים אחרות, כל פעם שאתם כותבים לצ'אט GPT, ה-T שבשם שלו עושה בדיוק את מה שראיתם בהדגמה: כל מילה במה שכתבתם בודקת את החוטים שלה לכל המילים האחרות.
צעד 9: אם הטרנספורמר מ-2017, מה השתנה ב-2022?
רגע. אם הטרנספורמר קיים מ-2017, למה כולם שמעו על צ'אט GPT רק בסוף 2022? כי הטרנספורמר הוא המנוע, לא המכונית. בין המנוע לבין מה שאתם מכירים היו עוד שלושה צעדים.
גודל. ב-2020 אופן איי איי פרסמה את GPT-3: אותה רשת של מילים וחוטים, רק ענקית.
175 מיליארד מספרים (פרמטרים), המספרים שקובעים איזה חוט יתעבה ומתי. זה יותר מעשרים מספרים לכל אדם בעולם (החשבון שלנו). לפי המאמר שלהם, זה פי עשרה מכל מודל דומה שהיה לפניו.
הרשת הזאת ידעה להשלים כמעט כל משפט שהתחילו לידה. אבל להשלים משפט זה לא אותו דבר כמו לענות למה ששאלתם.
ללמד אותו לענות. לפני ההשקה, אופן איי איי אימנה את המודל עוד שלב: אנשים כתבו תשובות טובות ודירגו תשובות של המודל, והוא למד להעדיף את אלה שדורגו גבוה. בשפה המקצועית: אימון בעזרת משוב מבני אדם (RLHF).
בדימוי שלנו: לימדו את הרשת להדליק קודם כול את החוטים של מה ששאלתם, ולענות לעניין, במקום סתם להמשיך את המשפט. על השלב הזה יש הסבר מלא במאמר על מודל שפה.
לפתוח את הדלת לכולם. ב-30.11.2022 אופן איי איי השיקה את צ'אט GPT: חלון צ'אט רגיל, ובתקופת הניסיון בחינם. לפי הודעת ההשקה, הוא נבנה על מודל ממשפחת GPT-3.5. פתאום כל אחד יכול היה לכתוב שאלה ולקבל תשובה.
אז הנה התמונה המלאה: הטרנספורמר מ-2017 הוא המנוע שמאחורי צ'אט GPT. מה שהפך אותו לצ'אט GPT הוא הגודל, האימון לענות, והחלון הרגיל שנפתח לכולם.
המקור באנגלית
During the research preview, usage of ChatGPT is free. ... We trained this model using Reinforcement Learning from Human Feedback (RLHF) ... ChatGPT is fine-tuned from a model in the GPT-3.5 series ...מה הקשב לא עושה
כאן חשוב להבין: "קשב" זה שם יפה, וגם "חוטים" זה רק דימוי. אין שם מישהו שמקשיב, ואין שם חוטים.
העוביים הם חישוב של מספרים. המודל למד אילו חוטים להדליק מתוך מיליוני משפטים, ולא מתוך הבנה של מה זה ארון.
לכן הרשת לא מונעת טעויות. מודל עם קשב מצוין עדיין יכול להמציא תאריך בביטחון מלא (על זה: למה הוא טועה בביטחון). הקשב עוזר לו לקשר בין מה שכתוב לפניו. הוא לא יודע מה שלא כתוב.
איך זה נוגע לעסק שלכם
פרשנות של צוות האתר
בעל חנות מדביק לצ'אט הסכם של עשרה עמודים מספק, ושואל: "מה קורה אם אני מחזיר סחורה אחרי 30 יום?". התשובה נמצאת בסעיף בעמוד שמונה, ושם כתוב "בכפוף לאמור בסעיף 2". סעיף 2 נמצא בעמוד הראשון.
בקריאה בשורה, עד שהמודל מגיע לעמוד שמונה, העמוד הראשון, עם סעיף 2, כבר דהה. ברשת, המילים בסעיף של עמוד שמונה מותחות חוט ישר לסעיף 2. זו הסיבה שהכלים של היום יודעים לעבוד עם מסמך שלם שהדבקתם, ולא רק עם משפט.
אבל לרשת יש גודל. כמה מילים אפשר לפרוס בבת אחת זה מה שנקרא חלון הקשר, וכשהוא מתמלא, הדיוק יורד. ומה שלא נכנס לרשת, המודל לא רואה בכלל.
לכן הכלל המעשי נשאר אותו כלל: תנו לו את המקור עצמו, בקשו שיציין מאיזה סעיף לקח כל דבר, ובדקו בעין כל מספר ותאריך.
במשפט אחד
לפני 2017 המחשב קרא כמו מי שמקריא מכתב מילה אחרי מילה ושוכח את ההתחלה; הטרנספורמר פורש את כל המשפט בבת אחת, וכל מילה מדליקה חוט ישר למילים שחשובות לה, וכולן באותו זמן. זה ה-T ב-GPT, המנוע שמאחורי צ'אט GPT.
הצעד הבא
הבנתם איך הצ'אט קורא? עכשיו כדאי לראות איפה הוא עדיין טועה, בבדיקה אמיתית שעשינו: אפשר לסמוך על צ'אט GPT?. ואם רוצים לחזור צעד אחורה, למה מחשב בכלל עובד רק עם 0 ו-1: ביט, 0 ו-1, מאפס.
